現在、AI エージェントのスタックの多くは Python で作られています。
それには理由があります。Python には LangChain、LangGraph、LlamaIndex といった成熟したフレームワークがあり、周辺のエコシステムも試行錯誤に最適化されています。しかし私の場合は、最終的に Go で AI エージェント基盤を構築し、そのほぼすべてをゼロから実装することになりました。
本稿では、なぜその選択をしたのか、システムの成長とともに初期実装がどう破綻したのか、そしてクリーンアーキテクチャを軸にどう再設計したのかを説明します。あわせて、スレッドベースのチャットモデル、データベース設計、永続化の戦略、そして「とりあえず動く」状態から実際にプロダクトの中で使い続けられるものへ移行する過程で直面した、現実的なトレードオフについても取り上げます。
なぜ Go で AI エージェント基盤を作るのか
最初の理由は、思想的というよりは実務的なものでした。プロダクトのバックエンドが、すでに Go で書かれていたのです。
MVP の段階で別の Python サービスを導入すれば、デプロイ、レビュー、運用の複雑さが増します。既存の Go バックエンドの中にすべてを収め、まずはそこで素早く進めるほうが安上がりでした。
実際に作り始めてみると、Go には AI エージェントの基盤に意外なほど向いている性質がいくつもあることにも気づきました。
- goroutine で並行実行をシンプルに書ける
- SSE、WebSocket、gRPC を軽量に実装できる
- 単一のバイナリで済むことが多いため、デプロイが容易
- インターフェースによって抽象化の境界が明示的になる
- 依存関係をきれいに分離すれば、テスト容易性が高い
Go には Python ほど多くのエージェント向けツールがないため、実装コストはいくらか高くなります。その代わり、アーキテクチャ、永続化、オブザーバビリティ、長期的な保守性を、はるかに細かくコントロールできます。
なぜ LangGraph や LlamaIndex を使わなかったのか
理由の一部はタイミングです。その時点で、すでに Go で直接 MVP を作り始めていました。
しかし、構造的な理由もありました。以前のプロダクトで LangGraph Platform の上に AI エージェントシステムを構築したとき、プロダクトへの統合に関して、いくつかの点で想定以上に制約が多いと感じました。たとえば次のような点です。
- 内部状態がブラックボックスになりやすい
- 永続化やスレッド管理が、フレームワークの規約に従わざるを得ないことが多い
- モデルやツールが、フレームワーク固有の抽象に結合する
- 部分的な導入は見た目ほど簡単ではない
- エクスポート、ロギング、監査可能性の扱いが厄介になりうる
フレームワークは有用で、目的が高速なプロトタイピングであればなおさらです。しかし、AI が既存のバックエンドの中で長く使われる機能になるなら、メッセージをどう保存するか、ツールをどう実行するか、ストリーミングをどう扱うか、そして後からすべてをどうエクスポート・監査できるかを自分でコントロールできることを、私は非常に重視します。
そこで、エージェントフレームワークをシステムの中心に据えるのではなく、プロダクトのアーキテクチャを中心に保ち、エージェント層は薄く、差し替え可能なままにしておきたかったのです。
なぜクリーンアーキテクチャは AI エージェントに合うのか
AI エージェントのシステムは絶えず変化します。
モデルが変わり、プロンプトの形式が変わり、ツールが追加されては削除され、メモリの戦略も進化します。ストリーミングの要件が SSE から WebSocket や gRPC に移ることもあれば、検索パイプラインが置き換えられることもあります。Planner-Executor パターンも現れては消えていきます。
つまり、本当の課題は「LLM API をどう呼ぶか」ではありません。変更をどう隔離するかです。
まさにここで、クリーンアーキテクチャが役に立ちます。
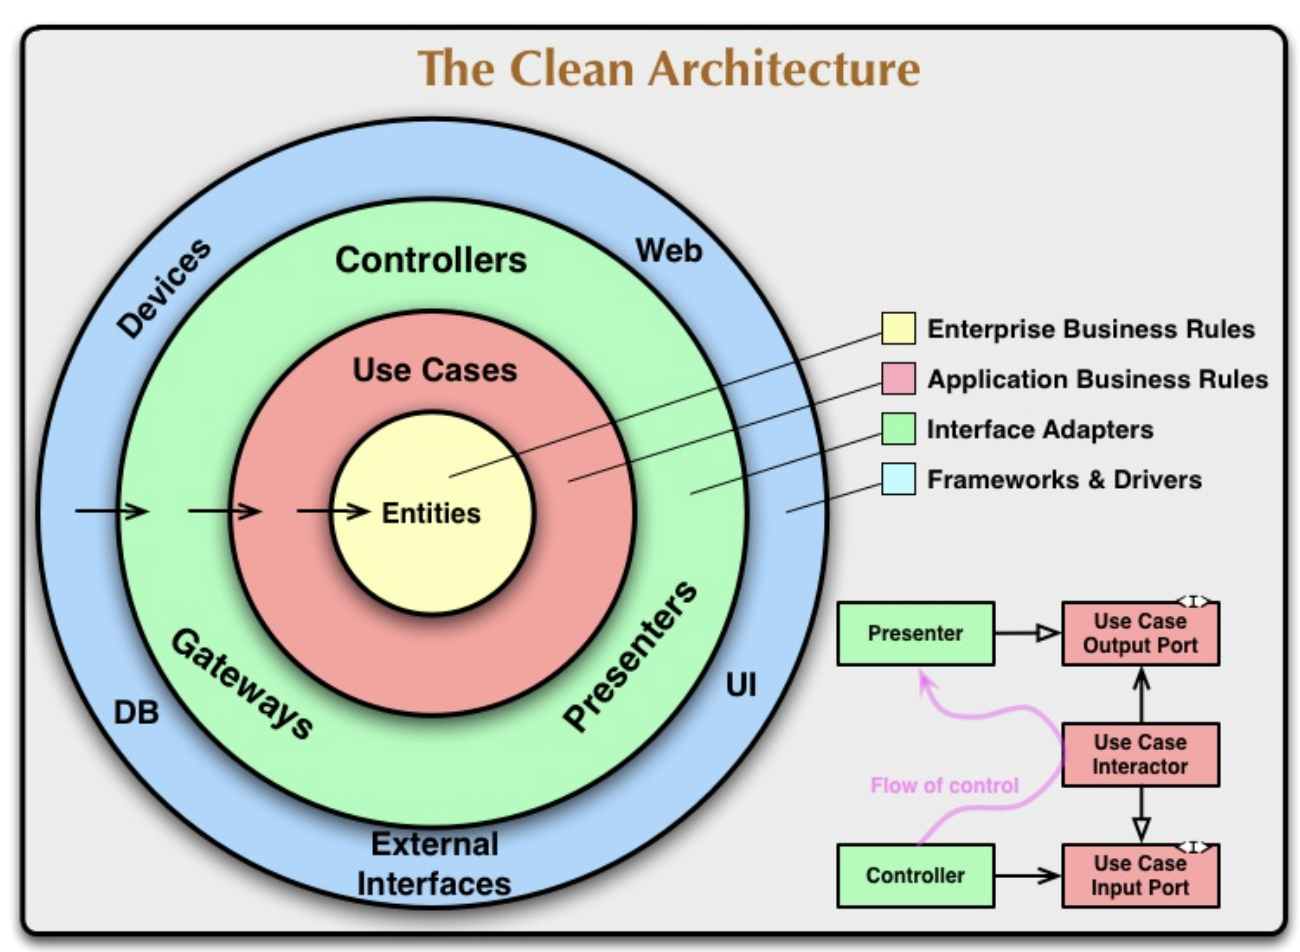 出典: The Clean Architecture – Robert C. Martin (Uncle Bob)
私の設計では、エージェントの中核となる概念を、次のような抽象に分離しています。
- Model: OpenAI、Anthropic、ローカル LLM
- Memory: インメモリ、PostgreSQL、Redis
- Tool: 外部 API 呼び出し、DB 参照、計算、検索
- Agent: ReAct 型の実行、ワークフローベースのエージェント、Planner-Executor
- Streaming: SSE、WebSocket、gRPC
これらの概念をインターフェースの背後に置くことで、アプリケーション層を壊さずに実装を差し替えられます。具体的には、次のようなことです。
- OpenAI から別のプロバイダに切り替えても、大規模なリファクタリングを強いられない
- ツールの追加や削除の影響が局所にとどまる
- メモリをインメモリから永続ストレージに変えても、エージェントのロジックを書き直さずに済む
- トランスポートを SSE から WebSocket に変えても、エージェント自体を再設計する必要がない
AI システムでは、この柔軟性がほぼ何よりも重要になります。
Before:モノリシックな /api/ai/chat
最初のバージョンは、意図的にシンプルにしました。
エンドポイントは /api/ai/chat の 1 つだけで、ほぼすべての処理をそこで行っていました。
- リクエストのバインド
- プロンプトの構築
- ツールの登録
- OpenAI の呼び出し
- SSE によるレスポンスのストリーミング
MVP の段階では、これが正しい選択でした。コード量を最小限に抑えられ、全体の挙動も追いやすいからです。1 つのファイルを見れば、処理の流れがすべてわかりました。
概念的には、構造は次のようになっていました。
POST /api/ai/chat
    ↓
[Presentation]
    ChatHandler
      ├─ request binding
      ├─ prompt building
      ├─ tool registration
      └─ agent execution
    ↓
[Application]
    ReactAgent
      ├─ OpenAI call
      ├─ tool execution
      ├─ state handling
      └─ streaming
    ↓
[Domain]
    prompt/context helpers
    ↓
[Infrastructure]
    OpenAI client
    PostgreSQL repository
このバージョンは、機能を検証するには十分でした。
しかし、すぐに構造上の問題に突き当たりました。
最初のバージョンの問題点
1. アプリケーション層が事実上 OpenAI に縛られていた
OpenAI の SDK が、アプリケーションロジックに直接埋め込まれていました。そのため、モデルプロバイダの変更は 1 つの実装を差し替えれば済む話ではなく、複数の層に影響しました。
- アプリケーションロジック
- エージェントの振る舞い
- レスポンスの処理
- エラー処理
「システムが OpenAI をサポートしている」のではなく、実態は「OpenAI がシステムに焼き付いている」状態でした。
2. ツールが具体的な実装と密結合していた
ツールレジストリと個々のツールが、アプリケーションロジックに近すぎました。リポジトリに直接触れるツールもあれば、モデル固有のデータ形式に依存するツールもありました。そのため、次のことが難しくなっていました。
- ツールを単独でユニットテストする
- 複数のエージェント間でツールを再利用する
- MCP のような別のツールプロトコルに対応していく
3. ストリーミングが SSE 前提でハードコードされていた
最初から SSE を前提に設計していたため、後から出力のトランスポートを変えるには、ハンドラからエージェントの実行フローに至るまで、大量のコードに手を入れる必要がありました。
WebSocket や gRPC が具体的に必要になる前から、アーキテクチャ上の問題はすでに見えていました。ストリーミングの詳細が、内側にまで深く漏れ出していたのです。
4. テストがつらかった
アプリケーション層が OpenAI の SDK、ツールの実装、メモリの実装に直接依存していたため、どれか 1 つをモックしようとすると、ほかも芋づる式に巻き込まれがちでした。
その結果、コードは結合テスト中心の方向に押しやられていきました。本当にやりたかったのはもっと単純なことで、Model、Memory、Tool の依存をモックし、エージェントの振る舞いだけを検証したかったにもかかわらず、です。
この時点で、エージェントのシステムにはきちんとしたアーキテクチャ上の境界が必要だと判断しました。
再設計:エージェントの中核を pkg/ai に移す
再設計の核となるアイデアはシンプルでした。
AI の中核となる抽象を専用のパッケージにまとめ、プロバイダ、永続化、トランスポートの詳細はその外に置く、というものです。
結果として、構造はおおよそ次のようになりました。
pkg/ai/
  agents/       // Agent の抽象と ReactAgent
  memory/       // Memory の抽象
  models/       // Model の抽象
  openai/       // OpenAI の実装
  prompts/      // プロンプトの抽象
  streaming/    // StreamEvent / StreamWriter の抽象
  tools/        // Tool / ToolRegistry の抽象
  types.go      // Message / ToolCall / TokenUsage

application/
  ai/tools/     // アプリ固有のツール
  usecases/     // AgentRunUsecase / ThreadUsecase / ThreadChatUsecase

infra/
  ai/memory/    // PostgreSQL によるメモリ
  ai/tools/     // デフォルトのツールレジストリ
  ai/streaming/ // SSE writer など

presentation/
  handlers/ai/  // HTTP ハンドラ
これは要するに、Go バックエンドの中に置いた、薄い自前のエージェント層です。
役割としては LangChain の軽量な社内版に近いのですが、プロダクトをフレームワークに合わせるのではなく、プロダクト自身のアーキテクチャに合うように作られています。
Model の抽象化
最初のステップは、プロバイダ固有の振る舞いを Model インターフェースの背後に隠すことでした。
type Model interface {
    Generate(
        ctx context.Context,
        messages []ai.Message,
        opts ...ai.ModelOption,
    ) (*Response, error)
}

type StreamingModel interface {
    Model
    GenerateStream(
        ctx context.Context,
        messages []ai.Message,
        opts ...ai.ModelOption,
    ) (<-chan streaming.StreamEvent, error)
}
これにより、2 つの関心事がきれいに分離されます。
- アプリケーションとエージェントは、モデルを呼び出していることだけを知っている
- プロバイダ固有のコードは別の場所にある
OpenAI 固有の実装は pkg/ai/openai の中に隔離されており、次の役割を担います。
- 内部のメッセージを OpenAI のリクエストメッセージに変換する
- ツール定義を、プロバイダの function calling の形式に変換する
- ストリーミング出力を、内部のストリームイベントに変換する
そのため、システムのほかの部分は OpenAI の SDK について何も知る必要がありません。
Memory の抽象化
会話履歴は Memory インターフェースを通じて扱います。
type Memory interface {
    LoadHistory(ctx context.Context, opts ...ai.MemoryLoadOption) ([]ai.Message, error)
    Save(ctx context.Context, msg ai.Message) (*ai.StoredMessageInfo, error)
    Clear(ctx context.Context) error
}
最初はインメモリの実装を使っていました。その後、PostgreSQL による永続化に置き換えました。
重要なのは、メッセージがメモリ上に保存されているのか、Postgres に保存されているのか、それ以外の場所なのかを、エージェントは知らないということです。エージェントは、インターフェースを通じてメッセージを読み込み、保存するにすぎません。
これにより、メモリの戦略は構造的な依存ではなく、差し替え可能な関心事になります。
Tool の抽象化
ツールは、エージェントが外の世界とやり取りするためのインターフェースです。
type Tool interface {
    Name() string
    Description() string
    JSONSchema() map[string]any
    Call(ctx context.Context, args json.RawMessage) (any, error)
}

type ToolRegistry interface {
    Register(tool Tool) error
    Get(name string) (Tool, error)
    List() []Tool
    Execute(ctx context.Context, name string, args json.RawMessage) (any, error)
}
これにより、責務をきれいに分けられます。
pkg/ai/toolsが抽象を定義する- インフラ層がレジストリの実装を提供する
- アプリケーションのコードがプロダクト固有のツールを提供する
この分離は重要でした。プロダクトのツールはドメインのリポジトリやビジネスルールを必要とすることが多いのですが、エージェントの中核はそれらを直接知るべきではありません。
エージェント本体:ReAct 型の実行ループ
エージェントは抽象にのみ依存します。
ModelMemoryToolRegistryStreamWriter
そのため、エージェントのロジックは実行パターンだけに集中できます。
私の場合は、ReAct 型のループを実装しました。
- メモリから履歴を読み込む
- 動的なシステムプロンプトを差し込む
- ユーザーのメッセージを追加する
- モデルを呼び出す
- モデルがツール呼び出しを要求したら、それを実行し、ツールの結果を履歴に追加する
- 再びモデルを呼び出す
- 最終的な回答が返ってきたら、それを永続化して実行を終了する
エージェントは HTTP を知りません。SSE のことも特に知りませんし、PostgreSQL がどう動くかも知りません。知っているのは、メッセージの流れ、ツール呼び出し、停止条件をどうオーケストレーションするかだけです。
この境界こそが、再設計で最も価値のある部分でした。
単発のチャットからスレッドベースのチャットへ
第 2 フェーズでの大きな変更は、チャットを単発のリクエストとして扱うのをやめ、本来のスレッドとしてモデル化し始めたことです。
中核となるドメインエンティティを 3 つ導入しました。
- Agent: エージェントの定義と設定
- Thread: 会話のセッション
- Message: スレッド内の個々の要素
これは、ステートレスな /chat エンドポイントよりも、プロダクトの実情にはるかによく合います。
Agent
Agent エンティティは、次のような設定を保持します。
- 名前
- 説明
- モード
- 有効なツール
- モデル
- temperature
- 最大トークン数
- タイムアウト
- メタデータ
Thread
Thread エンティティは、次を保持します。
- 所有者とテナント
- 紐づくエージェント
- タイトル
- ステータス
- メタデータ
- 最終メッセージのタイムスタンプ
Message
Message エンティティが保持するのは、次の項目です。
- スレッド ID
- ロール(
user、assistant、system、tool) - 構造化されたコンテンツ
- メッセージの順序
- ツール呼び出し
- ツール呼び出し ID
- トークン使用量
- タイムスタンプ
このモデルによって、デモ用のエンドポイントではなく、プロダクトレベルのチャットシステムを作れるようになります。
データベース設計
データベースのスキーマは、意図的にシンプルにしました。
agentsthreadsmessages
大きな意味を持った設計上の選択の 1 つが、メッセージに message_index を持たせたことです。
これには、いくつかの利点がありました。
- 順序がタイムスタンプに依存せず、明示的になる
- 最新 N 件のメッセージを簡単に読み込める
- 挿入や編集といった将来の機能にも対応しやすくなる
些細なことに聞こえますが、チャットシステムでは、永続化、デバッグ、リプレイを気にし始めた途端に、安定した順序付けの重要性が増します。
インメモリの履歴を PostgreSQL のメモリに置き換える
スレッドのモデルができたので、次のステップはメモリの裏側を PostgreSQL にすることでした。
Postgres の実装が行うことは、主に 2 つあります。
履歴の読み込み
スレッドに属するメッセージを message_index 順に取得し、内部の ai.Message オブジェクトに変換します。
意図的に加えた細かな工夫の 1 つが、永続化されたデータから再読み込みする際に、システムメッセージを除外することです。システムプロンプトは実行のたびに動的に生成されるため、通常の保存された履歴と同じように扱いたくなかったのです。
メッセージの保存
保存時、実装は次のことを行います。
- 次の
message_indexを割り当てる - ツール呼び出し ID を扱う
- メッセージの可視性を決める
この可視性という概念は役に立ちました。たとえば、
- ユーザーに見せるメッセージは、エンドユーザー向けの UI に表示できる
- 内部的なツールの出力や途中のアシスタントメッセージは、ユーザーからは隠したまま、デバッグや監査には使える
これにより、エージェントが実際に行っていることと、プロダクトの UI が見せるべきものとを、はるかにきれいに分離できます。
ユースケースとハンドラ
抽象ができあがると、アプリケーション層はずっとシンプルになりました。
AgentRunUsecase は、オーケストレーションを担います。
- アプリ固有のコンテキストを解決する
- ツールレジストリを構築する
- そのユースケースに関係するツールを登録する
- モデルファクトリを使ってモデルを構築する
- エージェントを構築する
- それを実行する
言い換えれば、ユースケースはどの部品を組み立てるかを選びますが、エージェントのロジックそのものは持ちません。
プレゼンテーション層は、さらに薄くなっています。ハンドラがやるべきことは次だけです。
- リクエストを検証する
- 認証を行う
- ストリームライターを作る
- 適切なユースケースに処理を委譲する
つまり、HTTP の関心事は HTTP の関心事のまま、AI の関心事は AI の関心事のままに保たれます。
この分離は、まさに最初から望んでいたものでした。しかし、それが手に入ったのは明示的な抽象を導入してからです。
実装時の現実的な落とし穴
再設計でアーキテクチャは改善しましたが、実装上の罠がなくなったわけではありません。
特に重要だった 2 つを紹介します。
1. ユーザーのメッセージが誤って二重に保存されていた
ある時点で、ユースケースとエージェントの両方が、同じユーザーのメッセージを保存していました。
- ユースケースが実行前に保存していました
- エージェントが、履歴を読み込んでユーザーの入力を追加した後に、もう一度保存していました
責務の境界を理解してしまえば、修正は単純でした。
エージェントが管理するすべてのメッセージ(ユーザー、アシスタント、ツール、そしてシステム関連の内部フロー)は、エージェント側がメモリを通じて保存すべきです。ユースケースがその責務を重複して持つべきではありません。
2. ストリーミングのレスポンスが永続化されていなかった
トークンの差分をクライアントに直接ストリーミングしていると、保存すべき最終的なアシスタントメッセージは自動的には手に入りません。
そのため、エージェントはストリーミングしたテキストを明示的に蓄積する必要がありました。
- テキストの差分をすべてバッファに集める
- その差分は、引き続きクライアントにストリーミングする
- ストリームが終わったら、結果がツール呼び出しではなく最終回答であれば、集めたテキストを 1 つのアシスタントメッセージとして保存する
この手順がないと、UI には回答がリアルタイムに表示されるのに、データベースには最終的なレスポンスが実際には残りません。
この種の問題は、トランスポートと永続化のロジックが明確に分離されていないと見落としやすいものです。
再設計で何が楽になったか
最大の改善はエレガントさではありません。変更が局所的になったことです。
再設計後は、次のようになりました。
- モデルプロバイダを変更する際の影響範囲が、ずっと限定されるようになりました
- ツールの追加や削除が、コードベースの無関係な部分を汚染しなくなりました
- メモリの実装を変えても、エージェントのロジックを書き直す必要がなくなりました
- ストリーミングのトランスポートが、差し替え可能な出力の関心事になりました
- HTTP なしでエージェントの振る舞いをテストできるようになりました
- ユースケースレベルのオーケストレーションが明確になりました
実際、これで開発のループが変わりました。
ハンドラやエンドポイントのロジックの中で直接実験するのではなく、pkg/ai の中で自由にイテレーションを回し、その成果を後からアプリケーション層やプレゼンテーション層につなぎ込めるようになったのです。
これにより、実験も安定化もやりやすくなりました。
それでも残るトレードオフ
このアプローチを過大に売り込むつもりはありません。
Go で薄い自前のエージェント層を作るのは、AI 機能を画面に出すための最速の方法ではありません。デモが欲しいだけの場合や、そのシステムがプロダクトの中核機能になることがない場合は、既存のフレームワークを使うほうが十分に良い選択になりえます。
トレードオフは単純です。
- フレームワーク優先は、短期的な開発を速くします
- アーキテクチャ優先は、長期的なコントロールを高めます
AI の機能が既存の Go バックエンドの中で動き、きれいに永続化され、監査でき、観測可能で、時間とともに進化していく必要があるなら、アーキテクチャ優先の道のほうがずっと魅力的になります。
今後の拡張
この設計には、さらなる拡張の余地も残されています。
RAG
RAG は、少なくとも 2 つの方法で追加できます。
SearchDocumentsToolのようなツールとして- メモリの読み込みの中の検索ステップとして
ToolRegistry と Memory はどちらも抽象化されているので、どちらのアプローチも、エージェント層のほかの部分を不安定にすることなく後から導入できます。
マルチプロバイダのモデル
ModelFactory インターフェースがあれば、複数のプロバイダに素直に対応できます。
- OpenAI
- Anthropic
- ローカル LLM
これは後に、エージェントごとのモデル選択や、動的なモデルルーティングにまで発展させられます。
MCP と外部ツールプロトコル
ツールはすでに抽象化されているので、MCP をバックエンドとするツール層も、次の方法で統合できます。
- MCP に対応したツールを実装する
- あるいは、リモートのツール定義をレジストリに同期する
エージェントから見れば、それらもただのツールにすぎません。
まとめ
このプロジェクトから得た最も重要な教訓は、プロダクト向けの AI エージェント構築は、LLM API の呼び出しよりもはるかにシステム設計の問題だということです。
難しいのは次の点です。
- プロバイダへの依存を隔離する
- ツールの実行を構造化する
- メモリを正しく設計する
- 何を永続化するかを決める
- トランスポートの詳細をあちこちに漏らさずにストリーミングを扱う
- AI スタックが変わり続ける中でも、システムをテスト可能に保つ
私のユースケースでは、Go とクリーンアーキテクチャは、これらの問題を解くうえで非常に良い組み合わせでした。
AI ツールのエコシステムでは今も Python が圧倒的で、それには十分な理由があります。しかし、プロダクトのバックエンドがすでに Go で書かれていて、フレームワークの形をした後付けではなく、本物のプロダクトのサブシステムとして振る舞う AI エージェントシステムが欲しいなら、Go で薄い社内エージェント層を作るのは非常に現実的な選択肢です。
最初は遅くなります。
しかし、重要なところでコントロールが手に入ります。